 国际站
在国际学术评价体系中,当我们评估一本期刊的质量时,通常看科睿唯安的“影响因子(Impact Factor, IF)”。但是,当我们想要评估一场国际计算机顶会(如 CVPR, KDD),或者想要一个不受“单篇超高被引神文”干扰的稳健指标时,全球学者最看重的是由 Google Scholar(谷歌学术)发布的终极标尺:h5-index(h5指数)。
1. 核心定义:什么是 h5-index?
要理解 h5-index,首先要懂物理学家 Jorge E. Hirsch 提出的著名学术概念:h指数(h-index)。
-
h指数的定义:一个人(或一本期刊/会议)发表的所有文章中,有 $h$ 篇文章每篇至少被引用了 $h$ 次。(例如:某学者的 h指数是 20,代表他有 20 篇文章,每篇文章的引用量都 $\ge$ 20 次。)
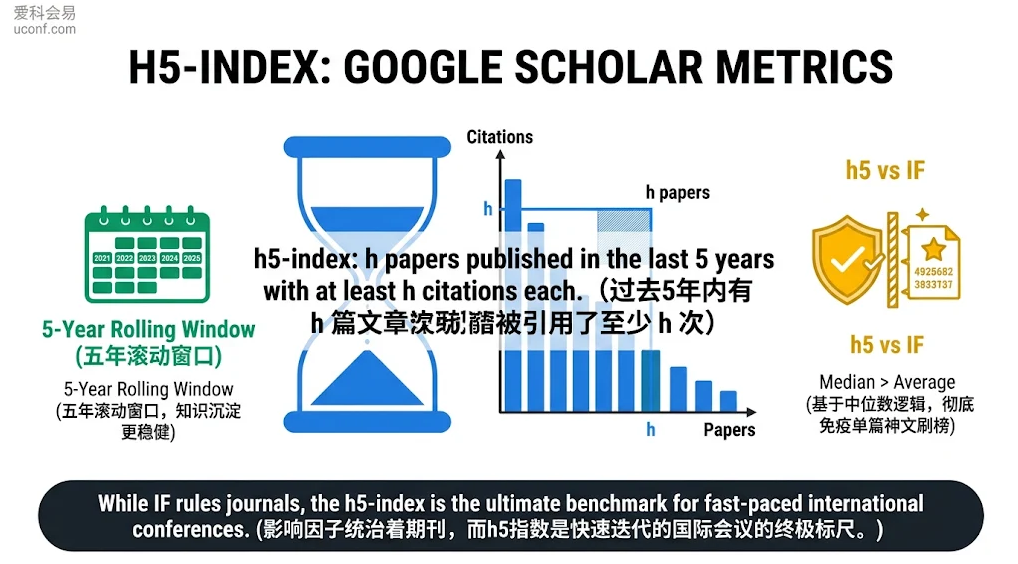
而 h5-index,就是给传统的 h指数加了一个严格的“时间锁”:仅计算过去 5 个完整日历年内发表的文章。
-
h5-index 官方计算逻辑:某出版物在过去 5 年内发表的所有文章中,有 $h$ 篇文章每篇至少被引用了 $h$ 次。
-
实战举例:假设 IEEE INFOCOM 会议的 h5-index 为 85。这就意味着,在过去 5 年里,INFOCOM 录用的论文中,有整整 85 篇文章,其单篇被引次数全都达到了 85 次或以上。
(注:除了 h5-index,谷歌学术还会同时公布 h5-median(h5中位数)。它是构成 h5指数的那 $h$ 篇文章中,引用次数的中位数,用于进一步衡量头部文章的爆发力。)
2. h5-index 与 影响因子 (IF) 的三大本质区别
为什么学术界在有了影响因子之后,依然极度推崇 h5指数?因为这二者的底层算法逻辑完全不同。
① 算法基因:平均主义 vs 中位数防守
-
影响因子 (IF) 是一个“平均数”。它的分子是总引用量,分母是总文章数。这种算法有一个致命漏洞:如果一本普通期刊发表了一篇现象级的医学综述(被引上万次),这单篇文章就能把整本期刊的平均分拉高 5 倍。这就是所谓的“刷榜”。
-
h5-index 是基于“中位数/木桶原理”。它根本不看您最牛的那一篇文章被引用了十万次还是一百万次。哪怕您有 1 篇文章被引用了 1 亿次,但其他文章都是 0 引用,您的 h5-index 依然只有可怜的 1。h5指数只奖励那些“持续、稳定输出大批量高质量文章”的出版物,彻底免疫了“单篇神文刷榜”现象。
② 评价窗口:2年 vs 5年
-
影响因子 (IF) 只看过去 2 年 的文章在当年的引用。这对于计算机、材料、生物工程等知识沉淀需要更长周期的学科来说,过于急功近利。
-
h5-index 看的是过去 5 年 的滚动窗口期,它给予了学术成果更长的时间去发酵,评价结果更加沉稳、客观。
③ 适用范围:期刊专属 vs 会议克星
这是最核心的现实区别。
-
影响因子 (IF) 是 JCR 系统专有的,它几乎不收录纯学术会议(Proceedings)。
-
Google Scholar 属于全网抓取机制,因此 h5-index 是全球计算机科学(CS)领域评估顶级国际会议(如 CORE A 或 CCF A类顶会)最权威、最核心的量化量表*。在 CS 领域,谈论会议的影响因子是外行的表现,比拼 h5-index 才是内行的共识。
3. 如何查询出版物的 h5-index?
要获取最准确的官方数据,您不需要任何付费数据库:
-
打开浏览器,访问 Google Scholar Metrics(谷歌学术指标) 官方主页。
-
您可以直接在搜索框输入期刊或会议的英文全称(如 International Conference on Machine Learning)。
-
系统会自动按照
h5-index和h5-median列出最新的指标数据,并提供该领域排名前 20 的出版物榜单供您横向比对。
总结与选刊/选会建议: 在进行高水平学术投稿时,如果您追求的是满足国内僵化的行政报销与基础毕业红线,影响因子(IF)和中位数分区依然是硬通货;但如果您追求的是行业内真正的学术口碑、或者准备在强迭代的工程技术与人工智能领域投递国际顶会,h5-index 超过 50 甚至 100 的平台,才是真正能让您的学术履历在海外学术圈发光的黄金阵地。