 国际站
为什么导航软件能够根据道路状况推荐路线?电商平台如何判断哪些商品可能符合用户需求?气象机构又如何利用大量观测数据预测天气变化?
这些应用都离不开数据处理与分析。但数据本身并不会自动产生价值。原始记录可能存在重复、缺失、格式不一致和测量误差,只有经过采集、整理、存储、分析和验证,才能形成可靠的信息。
从技术角度看,大数据的关键不只是“数据量大”,而是如何在合理的时间和成本内,从复杂数据中提取有用信息。
一、什么样的数据需要大数据技术?
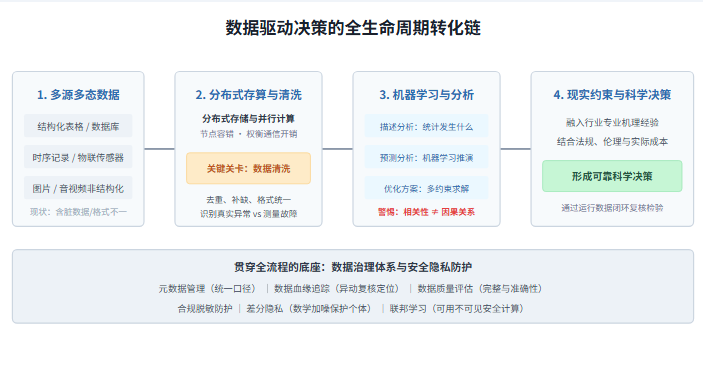
数据可以来自多种渠道,例如传感器、网站访问记录、卫星影像、医疗设备和工业控制系统。
不同来源的数据在结构和质量上差异很大。有些数据是结构清晰的表格,有些是图片、音频和视频,还有些是设备持续产生的时间序列记录。
传统单机系统在处理规模有限、结构简单的数据时通常已经足够。但当数据量、更新速度或数据类型复杂到超出单一系统的处理能力时,就可能需要采用分布式存储、并行计算等技术。
大数据系统通常需要同时考虑数据规模、处理速度、数据多样性、可靠性和使用成本。并非所有数据任务都必须采用复杂的大数据平台,合理选择技术同样重要。
二、海量数据如何被存储和处理?
当数据规模增大时,将所有数据交给一台服务器处理可能会遇到存储容量、内存和计算速度等限制。
分布式系统采用了不同的思路:将数据或计算任务分配给多台计算机,由它们协同完成工作。
例如,一个大型数据处理任务可以先被拆分成多个较小的任务,分别在不同节点上执行,最后将结果汇总。这样能够提高并行处理能力。
分布式存储系统也可以将数据分散保存在多个节点上,并通过副本机制或其他容错设计降低部分设备故障造成的数据丢失风险。
不过,分布式系统并非节点越多就一定越快。节点之间需要交换数据,任务拆分和结果汇总也会产生开销。如果任务本身规模很小,分布式处理甚至可能不如单机方案高效。
因此,工程设计需要在计算规模、通信开销、可靠性和资源成本之间取得平衡。
三、数据清洗为什么是分析工作的重要环节?
假设某个城市希望利用交通数据分析道路拥堵情况。如果传感器时间记录不一致、部分设备重复上报,或者某些道路的观测数据缺失,分析结果就可能产生偏差。
数据清洗的目的,就是识别和处理这些问题。
常见工作包括:
- 检查缺失值和异常值;
- 识别重复记录;
- 统一时间、单位和编码格式;
- 核对数据字段之间的逻辑关系;
- 记录数据来源与处理过程。
但数据清洗并不意味着把所有异常数据都删除。异常值可能来自设备故障,也可能反映真实的突发事件。例如,交通流量突然升高可能是测量错误,也可能是大型活动结束后的真实变化。
因此,数据处理需要结合业务背景,区分无效记录和具有分析价值的异常现象,并保留必要的处理记录,以便后续复核。
四、机器学习如何从数据中发现规律?
经过整理的数据可以用于统计分析、数据挖掘和机器学习。
不同方法解决的问题并不相同。
描述性分析回答“发生了什么”,例如统计某条道路在一天中不同时间段的平均车速。
预测分析尝试回答“接下来可能发生什么”,例如根据历史交通流量、天气和时间信息预测未来一段时间的拥堵程度。
优化分析则关注“怎样做更合适”,例如在满足道路容量和交通规则的前提下,寻找更合理的信号灯控制方案。
机器学习模型可以从历史样本中学习输入变量与目标结果之间的关系。训练完成后,模型再对新的数据进行预测。
但预测并不等于因果解释。即使两个变量在历史数据中高度相关,也不能直接证明其中一个导致了另一个变化。如果需要评估某项政策或措施的真实效果,还需要采用合适的实验设计、因果推断方法或其他验证手段。
五、数据治理为什么不可缺少?
数据治理是确保数据能够被正确理解、可靠使用和安全管理的一系列制度、流程与技术措施。
例如,一家企业可能同时使用多个系统记录客户信息。如果不同系统对“客户”“订单完成时间”或“产品类别”的定义不一致,即使数据存储得再多,也可能难以进行准确分析。
数据治理需要明确数据定义、质量要求、责任归属、访问权限和生命周期管理规则。
其中,元数据管理用于描述数据的含义、来源、结构和更新方式;数据质量管理则关注准确性、完整性、一致性和及时性等指标。
此外,数据血缘可以帮助追踪数据从原始来源到最终报表的处理过程。当分析结果出现异常时,工作人员能够更容易定位问题发生在哪个环节。
数据治理并不是为了增加管理手续,而是为了让不同部门能够在明确规则下共享和使用数据,减少重复建设和错误决策。
六、如何在数据利用与隐私保护之间取得平衡?
数据分析可能涉及个人信息、企业经营记录或其他敏感内容。即使数据在分析过程中不直接显示姓名,也不能简单认定其完全匿名。
例如,如果某条记录包含精确位置、时间和独特行为特征,仍有可能与其他信息结合后识别个人。
因此,数据治理需要结合具体用途采取适当措施,包括最小化采集、限制访问权限、控制保存期限、脱敏处理和审计记录等。
在某些场景下,差分隐私可以通过引入经过严格设计的随机噪声,限制单个个体数据对整体统计结果的影响;联邦学习则可以减少集中收集原始训练数据的需要。但这些方法都有适用条件和技术代价,需要根据隐私目标、数据类型与应用需求进行设计。
七、数据分析如何真正服务现实问题?
以城市交通管理为例,系统可以整合道路传感器、车辆位置、天气和交通事件等信息,建立交通状态分析模型。
首先,需要对不同来源的数据进行时间和空间对齐;其次,利用统计分析和机器学习识别拥堵规律;随后,将预测结果提供给交通管理系统或决策人员;最后,还要通过实际运行数据检验措施是否有效。
如果模型预测准确率较高,却没有考虑道路容量、交通规则或应急车辆通行需求,最终方案仍可能不适合实际应用。
这说明数据分析不是孤立的算法任务,而是一个将数据质量、专业知识、模型验证和现实约束结合起来的过程。
结语
海量数据能够为科研、产业和公共服务提供新的分析基础,但数据量大并不意味着结论必然准确。可靠的数据应用需要合理的存储架构、规范的数据处理流程、适当的分析方法,以及贯穿数据生命周期的治理与安全机制。
从数据采集到结果验证,每一个环节都可能影响最终判断。只有将技术能力与业务知识、质量管理和隐私保护结合起来,数据才能真正转化为有价值的信息。